
Как подготовить интернет к обучению LLM: архитектура пайплайна на сотнях миллиардов документов
1 декабря, 13:30, «Кейптаун»
Мнение Программного комитета о докладе
Спикер расскажет о том, как в Сбере с помощью ИИ строят пайплайны для обработки данных в разных модальностях: текста, видео, звука. Данные затем используются для обучения ИИ-моделей, но перед этим нужно отфильтровать то, что будет полезным, сохранить связи и оптимально загрузить GPU.
Целевая аудитория
ML, AI Researchers, ML Ops, архитекторы, DevOps
Тезисы
Как строить pipeline на сотни миллиардов сырых HTML-страниц без бесконечного GPU-кластера. Погрузимся в архитектуру распределённой обработки веба: extraction основного контента, LID, document-level filtering, дедупликацию и каскадную маршрутизацию сложных страниц. Покажем, как сочетать CPU-first алгоритмы, лёгкие классификаторы и GPU-fallback, а также какие инженерные компромиссы возникают между throughput, стоимостью обработки и качеством итоговых данных.
Спикеры
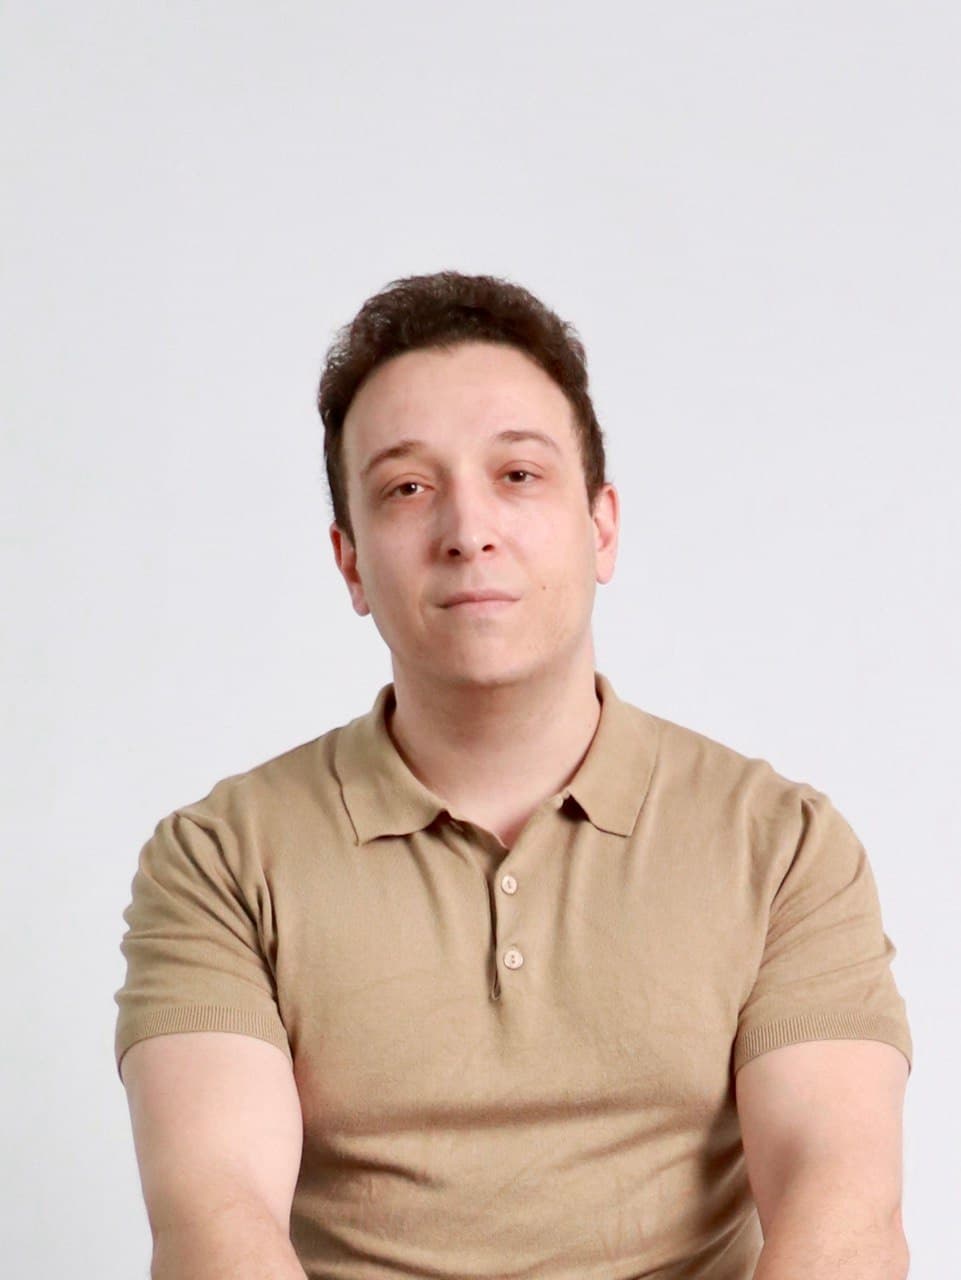
ПАО Сбербанк
Другие доклады секции
Райффайзен Банк
Диасофт
Диасофт
Звук
Битрикс24
Группа Сбер / VSRobotics
wikilect.com
Независимый эксперт. Ex-Head of Mobile в Леруа Мерлен.
SIPKI Technologies